Machine Learning
Fondamenti del machine learning: paradigmi supervised, unsupervised, semi-supervised e reinforcement learning; classificazione e regressione, bias-varianza, cross-validation, gradient descent e minibatch SGD.
Il Machine learning è un sotto campo dell'AI che ha le caratteristiche di:
- Imparare tramite esempi
- Costruisce ipotesi sul mondo tramite gli esempi che gli sono stati forniti
- Usa le ipotesti imparate per fare predizione/inferenza di dati non ancora visti
Il machine learning è il duale dell'AI simbolica, il machine learning può essere visto come un approccio "bottom up", dove l'intelligenza viene creata partendo da esempi fino al creare un modello generale usato per predizione/inferenza. L'ai simbolica è un approccio top down, dove l'intelligenza è creata tramite ipotesti generali fino ad arrivare ai casi più peculiari.
Il machine learning ha il vantaggio di non richiedere l'anticipazione di tutti i futuri scenari in cui l'agente può trovarsi. Alcune volte non si sà come poter modellare un problema tramite l'approccio simbolico, mentre gli algoritmi di machine learning possono trovare pattern nei dati.
In maniera più formale, lo scopo del machine learning è di "imparare" una funzione che mappa un certo input ad un output .
Di solito è un vettore n-dimensionale , dove ogni componente (elemento) di è chiamata "feature", quindi è un vettore di feature. Mentre è spesso un singolo valore numerico, oppure può essere a sua volta un vettore m-dimensionale.
è difficile che la funzione venga imparata ottimalmente, spesso ci si accontenta di una funzione che approssima , in questo caso è quello che viene chiamato il modello di machine learning.
Per far "imparare" , si parte da un set di esempi e (possibilmente) gli output di questi esempi .
Training del modello
Il processo di computazione, o learning di un modello di machine learning è detto anche "model training" oppure "model fitting". Mentre il processo di usare un modello per calcolare l'output di un input non ancora visto è detto "inferenza"
Classificazione & Regressione
Sono i due diversi modi in cui un modello di machine learning può fornire il proprio risultato.
Quano un output di un dominio corrisponde ad un numero finito di valori (per esempio dei tag) allora si parla di un problema di Classificazione
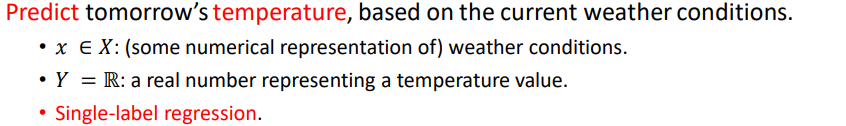
Quando un output di un dominio sono numeri (non finiti), allora si chiama Regressione
Multiclasse e Multioutput
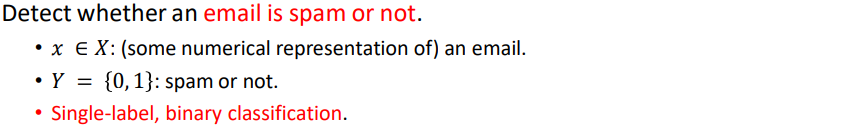
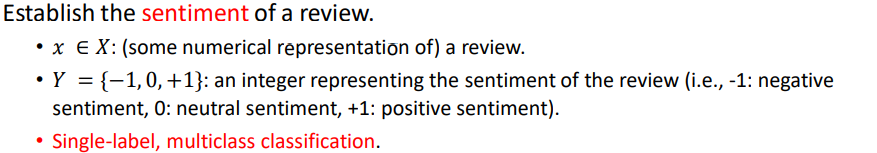
Quando l'output è un singolo valore, allora il task è considerato "single label". Allo stesso modo, un task single label può essere detto binario se lo scopo è assegnare un output tra 2 valori possibili, mentre è detto multiclasse se sono più di 2.
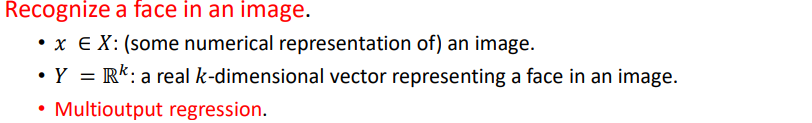
Quando l'output non è un singolo valore, allora il task è chiamato "multilabel" o "multioutput" o "multivariate". Per esempio "Multilabel classification" e "Multioutput regression"
Tipi di learning
Ci sono diversi paradigmi di insegnamento in machine learning, in base al tipo di dati a disposizione.
Supervised learning
è quando abbiamo sia gli esempi che gli output di questi esempi. Gli output sono dati da una fonte (possibilmente) veritiera, ed è chiamato "ground truth", Il set di training a questo punto è visto come gli esempi e gli output di questi esempi.
Esempi di ciò sono:
- Spam detection (si ha sia il messaggio e un valore che ci dice se è spam o meno)
- Predizione temperatura (si ha sia la temperatura che lo stato metereologico in quel momento)
- Face recognition (si ha l'immagine e la posizione in cui è contenuta una faccia)
- etc...
Una variante simile al Supervised learning ma dove gli esempi sono annotati da esseri umani tramite la loro "supervisione" è chiamata "Self supervised learning"
Un modello è estratto da uno spazio di ipotesi di possibili funzioni, senza restrizioni. potrebbe essere una funzione lineare, una funzione polinomiale, una rete neurale, etc...
Nella creazione di un modello di machine learning, i dati vengono divisi in training set e test set. Il training set è usato nella creazione del modello di machine learning, mentre il test set viene usato per valutare quanto bene il modello riesce a predirre i dati.
é importante non mischiare i due, dato che lo scopo del machine learning è vedere quanto bene si adatta il modello a dati non visti, se fossero parte del training set, potrebbe darci un idea sbagliata sulla qualità del modello.
A tale punto, è utile conoscere due criteri:
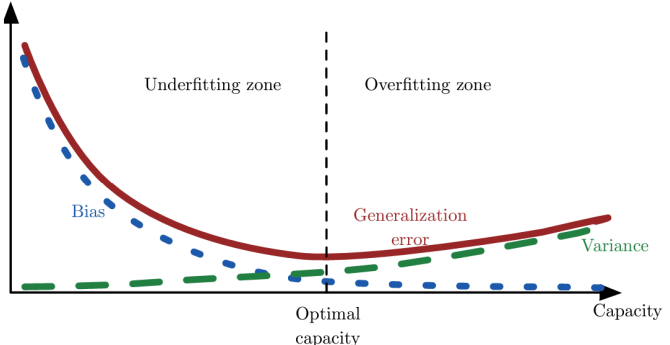
- Bias, ci dice quanto bene il modello riesce ad usare i dati del training set per imparare. Un bias alto vuol dire che il modello deve fare grandi assunzioni per predirre l'output, e quindi non seguirà molti i dati di training iniziali. Mentre un bias basso ci dice che il modello sta effettuando poche assunzioni, e seguirà i dati di training iniziali.
- Variance, ci dice quanto è sensibile il modello a cambiamenti del training set. Una varianza bassa vuol dire che il modello è meno sensibile a cambiamenti del training set, e produce stime accurate anche con sottoinsiemi del training set. Una varianza alta vuol dire che è più sensibile ai cambiamenti del training set.
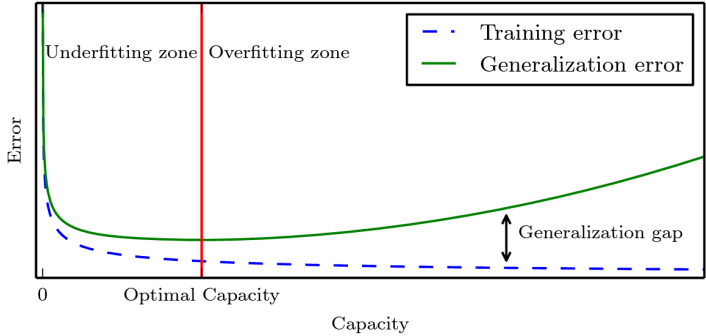
Un modello con alto bias è detto underfitting, cioè che non riesce ad usare in maniera efficace il training set, e che quindi avrà una bassa qualità nel momento di inferenza
Un modello con varianza alta è detto overfitting, cioè che è troppo specializzato sui dati nel training set, e che quindi non avrà una buona "generalizzazione" su dati mai visti, ed avrà una buona qualità solo su dati visti.
Un buon modello di machine learning deve bilanciare i due criteri di bias e varianza per migliorare il più possibile la qualtità del modello.
Iperparametri, training set, validation set e test set
Come detto, lo scopo del model training è quello di trovare i migliori parametri di una funzione per migliorare il più possibile la qualità del modello. Oltre a questi parametri, esistono anche gli "iperparametri", che servono come "configurazione" del modello di machine learning, come per esempio il grado massimo dei polinomi nella funzione, il numero di strati in una rete neurale, il numero di alberi in una random forest, etc...
Gli iperparametri sono migliorati tramite un dataset a parte chiamato validation set, che è distinto da sia il test set e training set.
Quindi, per pter effettuare il machine learning su un task supervised, bisogna avere 3 dataset:
- Training set, che è usato per far imparare i valori dei parametri del modello.
- Validation set, che è usato per vedere quali iperparametri portano al miglior risultato.
- Test set, per effettuare una valutazione finale del modello su dati mai visti.
Di solito si fa ciò prendendo un dataset e suddividerlo in 3 tramite 80/10/10, cioè la percentuale di dati presenti nel training, validation e test set.
Cross validation
La suddivisione del dataset in training set e validation set diminuisce la quantità di dati disponibile per il training, che potrebbe a sua volta ridurre la qualità del modello.
Per ovviare a ciò, in caso della mancanza di una grande quantità di dati, si usa il cross validation, che suddivide il set iniziale di dati in gruppi (in maniera randomica, come la suddivisione precedente), e per si utilizza il gruppo come validation set, mentre tutti gli altri gruppi come training set. Utilizzeremo questi altri gruppi (per ogni iterazione) per fare training del modello.
Valori popolari per sono 5 e 10, e quindi si parla di 5/10 fold cross validation.
Anche con cross-validation, Bisogna comunque avere un test set separato
Unsupervised learning
Nel caso di unsupervised learning, abbiamo gli esempi ma non abbiamo le loro label (i valori di ogni esempio).
Nell'unsupervised learning, lo scopo è di solito di trovare i pattern che descrivono la struttura dei dati in input, anzichè mappare un input ad un output.
Esempi di task unsupervised sono:
- Clustering
- Anomaly detection
- Similarity search/detection
- Ranking
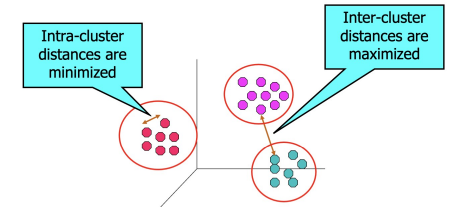
Per esempio il clustering è uno dei task più popolari, ha lo scopo di raggruppare degli oggetti in "cluster", dove in ogni cluster, un oggetto è considerato simile agli altri oggetti in quel cluster, ma differente rispetto a quello degli altri cluster.
Semi supervised learning
Come dice il nome, ci sono forniti gli esempi e solo alcuno di questi esempi hanno la loro corrispettiva label di output. Lo scopo di questo tipo di learning è di usare i dati per di esempio e le loro label (se presenti) per poi mappare un input ad un output.
Reinforcement learning
è un paradigma dove il modello impara interfacciandosi con il proprio ambiente. Vengono usati "premi" e "penalità" per dire all'agente quando un azione è giusta o sbagliata, e il modello userà queste informazioni per capire cosa fare in maniera tale da massimizzare i "premi" che riceve.
Representation learning
Il Representation Learning (o Feature Learning) è un tipo di apprendimento in cui l'obiettivo è imparare una rappresentazione numerica degli oggetti a partire dalla loro rappresentazione grezza. Lo scopo è ottenere automaticamente, senza l'uso di tecniche manuali di feature engineering, dei vettori numerici che rappresentino accuratamente gli oggetti.
Un'applicazione importante è l'uso delle rappresentazioni apprese come input per approcci di machine learning che richiedono dati numerici.
Esempi di applicazione:
- Imparare rappresentazioni per nodi in un grafo.
- Imparare rappresentazioni per unità testuali, come parole, frasi o paragrafi.